Guide du RAG documentaire en entreprise : architecture, déploiement local, cas industriel
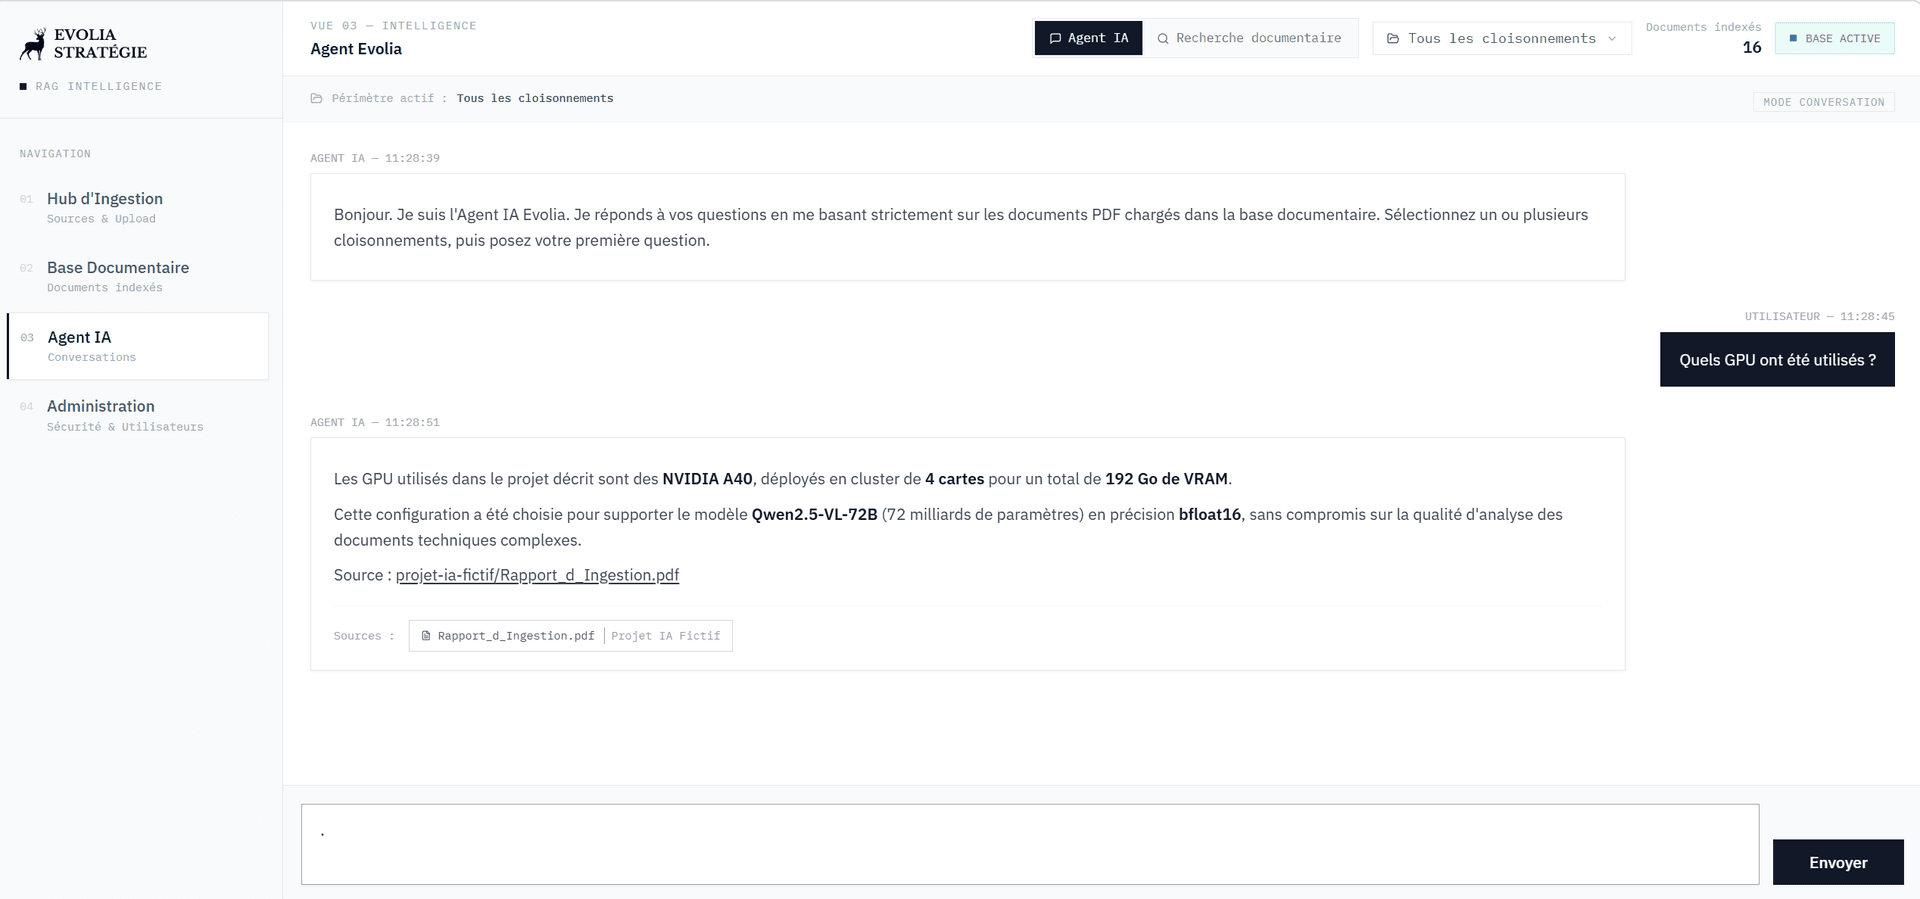
Le RAG (Retrieval Augmented Generation) est l'architecture qui permet à un LLM de répondre à des questions en s'appuyant sur votre propre base documentaire, plutôt que sur ses seules connaissances générales. C'est aujourd'hui la technologie qui génère le plus de valeur concrète dans les déploiements IA d'entreprise.
Pourquoi le RAG est la bonne réponse pour les entreprises
Les LLM ont deux limitations majeures pour les usages en entreprise : leurs connaissances sont figées à une date d'entraînement, et ils ne connaissent pas vos documents internes. Le RAG résout ces deux problèmes en permettant au LLM de consulter en temps réel une base documentaire mise à jour.
L'avantage complémentaire du RAG est la traçabilité des sources : contrairement au fine-tuning, le RAG cite les documents et les passages utilisés pour générer chaque réponse. C'est un facteur de confiance essentiel pour les équipes métiers.
Architecture d'un système RAG : les 5 composants
Le pipeline d'ingestion documentaire
Extraction du texte (PDF, Word, HTML, Excel), découpage en chunks cohérents, génération des embeddings, stockage dans la base vectorielle avec les métadonnées associées.
Le modèle d'embedding
Convertit vos textes en vecteurs numériques. Pour les documents en français, nous recommandons Sentence-BERT multilingue ou les embeddings Mistral, déployables localement.
La base de données vectorielle
Stocke les embeddings et permet les recherches par similarité en quelques millisecondes. Qdrant est notre recommandation pour les déploiements souverains.
Le moteur de retrieval
Convertit la question en vecteur, interroge la base vectorielle pour trouver les K chunks les plus proches (K=3 à 10), et applique éventuellement un reranking.
Le LLM de génération
Les chunks sélectionnés sont injectés dans le prompt avec la question. Mistral Large 2 ou Mixtral 8x7B sont d'excellents choix pour les documents techniques et juridiques en français.
Où faire tourner le RAG : en local ou dans le cloud ?
Toutes les briques ci-dessus existent en version open source et peuvent tourner sur votre propre serveur : c’est la voie que nous privilégions dès que les documents sont sensibles (plans clients, dossiers techniques, Diffusion Restreinte). Une API d’entreprise en cloud européen, sans conservation des données, reste possible quand vous la choisissez ou quand un besoin technique l’impose. Le choix se fait avec vous, au cas par cas.
Le cas des documents techniques industriels
La documentation industrielle pose des difficultés que les guides génériques ignorent : manuels scannés sans texte exploitable, tableaux et abaques, plans, normes. Un RAG utile dans un bureau d’études doit savoir lire une page comme une image pour retrouver la valeur d’un tableau, et citer la page d’où vient la réponse.
C’est ce que nous avons mis en œuvre avec Ametra Group (ingénierie défense, aéronautique, nucléaire) : un POC de RAG déployé en local, avec −60 % de temps de recherche documentaire constaté. Le détail est dans notre retour d’expérience Ametra.
Déployer un assistant documentaire en quatre étapes
- —Définir le périmètre : quels documents, pour quels utilisateurs, et une liste de vraies questions posées par les équipes.
- —Choisir l’architecture : en local ou en cloud, selon la sensibilité des documents et votre infrastructure.
- —Construire et indexer : ingestion, découpage, base vectorielle, droits d’accès alignés sur ceux de vos dossiers.
- —Tester sur les vraies questions : mesurer le temps de recherche avant et après, et la justesse des réponses sourcées.
Le découpage en chunks : un art délicat
- —Taille de chunk : 256 à 512 tokens pour les documents narratifs, 128 à 256 pour les documents techniques condensés.
- —Chevauchement (overlap) : 10 à 20 % entre chunks consécutifs pour ne pas couper les phrases à mi-chemin.
- —Découpage sémantique : préférez le découpage aux limites de paragraphes ou de sections plutôt qu'à taille fixe en caractères.
- —Métadonnées enrichies : ajoutez le titre de la section, le numéro de page et la date de mise à jour pour améliorer le reranking.
Évaluation d'un système RAG
Faithfulness
La réponse est-elle entièrement supportée par les documents ?
Answer relevance
La réponse répond-elle réellement à la question posée ?
Context recall
Les documents les plus pertinents ont-ils bien été retrouvés ?
Context precision
Les documents retrouvés sont-ils tous pertinents ?
Le framework RAGAS (open source) permet d'automatiser ces évaluations sur un jeu de questions de référence.
Un système RAG bien construit est l'investissement IA avec le meilleur ratio valeur/complexité pour les entreprises. En 4 à 12 semaines, vous pouvez déployer un assistant documentaire qui transforme radicalement la façon dont vos équipes accèdent à l'information interne.